TL;DR
你把问题交给云端 RAG 服务,它返回几段“最相关”的文档,本地大模型据此作答——但你没法确认,服务方真的在约定的数据库上、按约定的算法跑了检索,还是随手丢了个缓存、截断或带偏见的结果。zkRAG 就是来堵这个缺口的:它让服务方为一次 HNSW 近似最近邻搜索生成零知识证明,验证者只凭承诺和证明就能确认,结果确实是“在那张承诺过的图上按规矩搜出来的”,同时除了结果本身,学不到数据库的任何内容。在百万向量、128 维的标准基准上,一次典型查询的证明约 50 秒、验证约 1 秒、证明 0.5MB,比通用证明框架快一千倍以上。代价也很清楚:证明仍比明文查询慢三个数量级,而且它只保证“搜的过程没错”,不保证建图的过程没错。
论文信息卡
- 标题:zkRAG: Efficiently Proving RAG Retrieval in Zero Knowledge
- 作者:Yanze Jiang、Xinyang Yang(新加坡国立大学)、Xuanming Liu(浙江大学)、Yanpei Guo、Jiaheng Zhang(通讯作者,新加坡国立大学);前三位作者贡献相同
- 会议:IACR Cryptology ePrint Archive 预印本,编号 2026/709(2026 年 4 月 11 日提交、4 月 12 日收录);本文写作时尚未标注顶会录用信息,按预印本对待
- 原文链接:https://eprint.iacr.org/2026/709
背景
RAG 的工作方式今天已是常识:先把外部文档编码成向量存进数据库,查询时做一次近似最近邻搜索(ANNS),把最相关的几段喂给大模型当上下文。检索质量直接决定生成质量——漏段落会让模型编造,塞入被操纵的段落会让输出走偏。麻烦出在部署形态上:越来越多 RAG 以云服务交付,数据库和索引都握在服务方手里,客户端只能看到结果,看不到执行过程。论文提到一个真实教训:同一文档库、同一查询,两名用户却得到不同的 RAG 答案,根源就是检索环节返回了不同的文档块。
直觉的解法是“把整个检索过程写成零知识证明电路”,但这条路线在 HNSW 这里撞了墙。HNSW 是目前应用最广的图式 ANNS 算法:每个向量是一个节点,节点按随机层级分层,顶层稀疏、底层稠密;查询时从顶层入口贪心下行,到达底层后再做一次带优先队列的 best-first 搜索。它的搜索轨迹是数据依赖的:下一步去哪取决于刚算出的距离,优先队列随时在变,同一节点还会被反复访问。把这种动态过程硬塞进通用电路,证明者时间和内存都会爆炸,基线实测中通用框架在稍大一点的规模上就直接内存溢出。所以这篇论文真正的问题是“验证能不能便宜到可用的程度”——答案是针对 HNSW 的结构做专用证明。
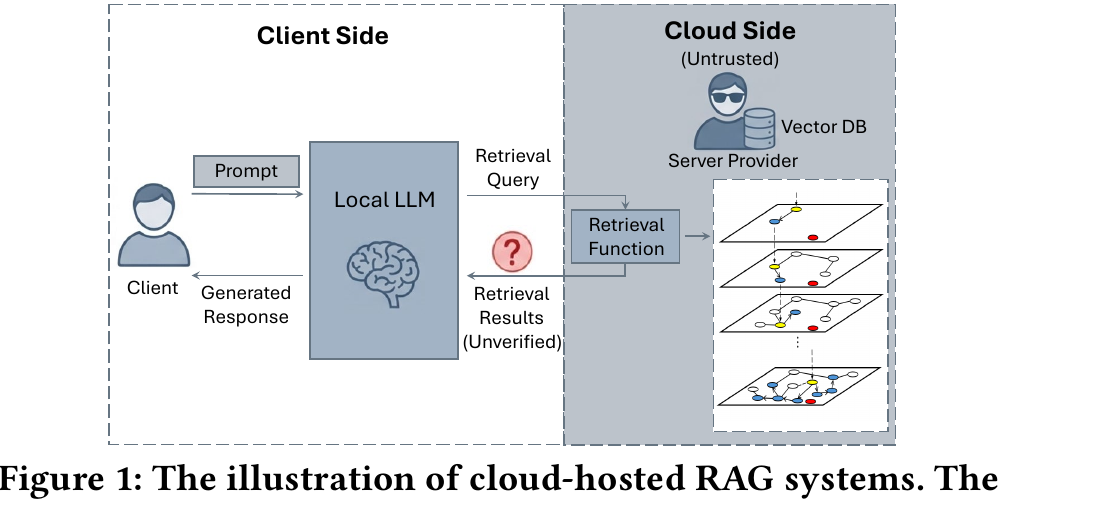
图:云端 RAG 服务中,检索函数的结果未经验证,客户端无法区分忠实执行与任意偏离(来源:论文原文图 1)
方法拆解
zkRAG 的整体思路是:把一次 HNSW 查询拆成“查表”和“查队列”两类可高效证明的子问题,再用统一的 PIOP(多项式交互式预言证明)框架拼起来,经多项式承诺与 Fiat-Shamir 变换得到非交互零知识论证。下面分四步讲。
第一步:离线承诺两张表,代价只付一次
服务方建好 HNSW 图后,对两张表做承诺,之后每次查询都复用:向量表每行是节点标识加向量,层级表每行是某节点在某层的邻居列表。两张表共 O(N) 行,百万规模的离线预处理约两天,但只做一次。关键选择是:承诺的对象是“图长什么样”,搜索过程的正确性留给在线证明去管。
第二步:混合查找论证,让在线证明者摆脱数据库规模
在线查询只访问搜索轨迹上的节点,数量记为 ℓq,远小于数据库规模 N。要证明“用到的节点和邻居关系确实来自承诺过的表”,自然的工具是查找论证,但现成方案要么在线代价带 O(N) 项,要么仍有对数尾巴。zkRAG 的混合查找论证把两边长处拼在一起:等式左边用单变量多项式编码,复用离线算好的缓存商式;右边改用多线性多项式编码,两边都做到 O(ℓq)。于是,在线证明者时间只随轨迹长度线性增长,与数据库规模无关——这是全文最关键的一步。
第三步:上层贪心搜索,距离只算一次
上层是逐层贪心:从入口出发,每层找离查询最近的邻居,一路下行到第 0 层。麻烦的是距离计算:朴素做法是每访问一次节点就算一次内积,而同一节点会出现很多次(上层重复约 2 倍、底层约 10 倍),维度动辄上百。解法是建一张“距离子表”:先把互不相同的访问节点挑出来,只对它们各算一次距离并承诺成表;之后每次需要距离,都改成查表,总代价是 O(m + d·m_unique),比反复算内积便宜得多。
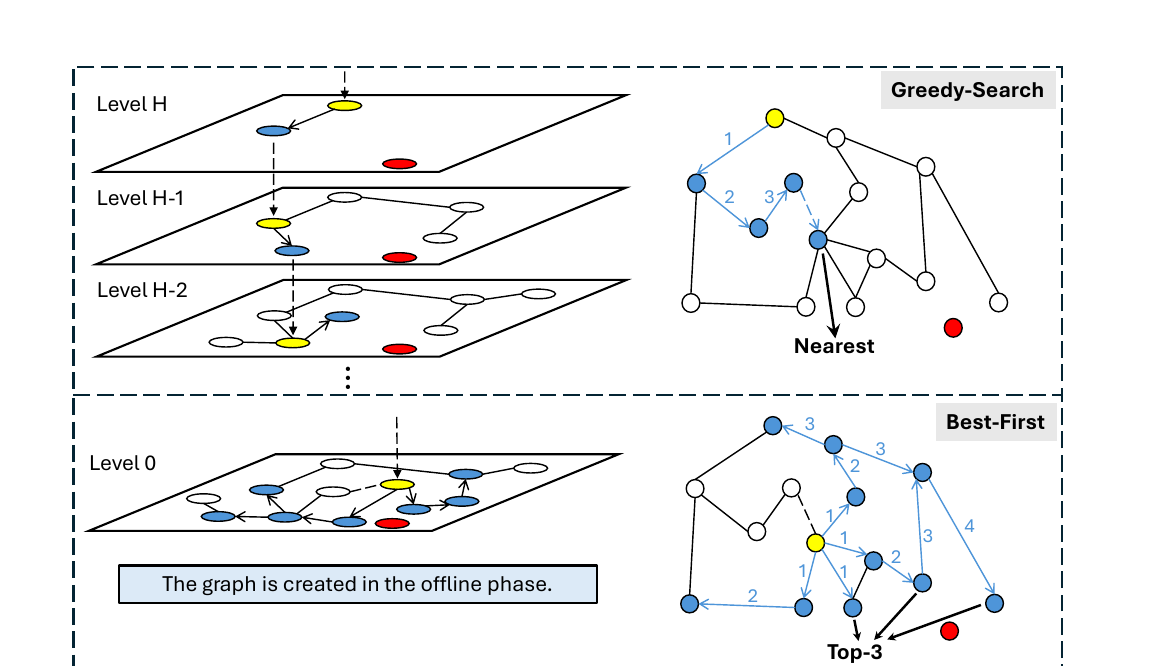
图:HNSW 查询分两段:上层逐层贪心下行,底层用优先队列做 best-first 搜索(来源:论文原文图 2)
第四步:底层 best-first 搜索,用检查器代替重算堆
底层是最难的一段,维护候选队列 C(无容量上限)、结果队列 R(容量固定为 efS,决定搜索精度)和已访问集合 V。朴素思路是“把堆操作都重算一遍”:每次弹出时扫描整个队列确认它确实是最小值,代价是轨迹长度的平方;用堆结构电路化也还有对数因子。论文换了一个思路:不证明“程序是怎么跑的”,只证明“见证满足一个检查器”,检查器只盯两条性质:多重集性质(最终状态等于初始状态加所有未删除的插入,且每次删除对应唯一一次此前的插入),以及优先队列性质(每次弹出的确实是当时的最小值)。
第二条性质的证明最精巧。对每个插入定义 maxlb(最大下界):它存活期间所有弹出元素中的最大值。论文证明,“每次弹出都是最小值”当且仅当“每个插入值都不小于自己的 maxlb”。而 maxlb 是否定义正确,可归结为两个辅助指针 prev 和 next:离它最近的前后两个“更大的删除”必须落在存活区间之外,这两个指针可用线性时间的单调栈算法算出。于是检查器做到线性时间,证明者代价是 O(ℓq),而不是 O(ℓq log ℓq) 甚至平方。
已访问集合 V 的处理是同一哲学:朴素做法是给每个节点维护一个比特位,代价 O(N);zkRAG 改用成员选择向量——轨迹每一步记一个 0/1 比特表示该节点是不是第一次出现——并用检查器验证其合法性,把代价降到 O(ℓq)。最后,各段子证明共享同一组承诺和随机挑战拼成一份证明;验证者只需做常数次承诺打开验证,验证时间和证明大小都是对数级。
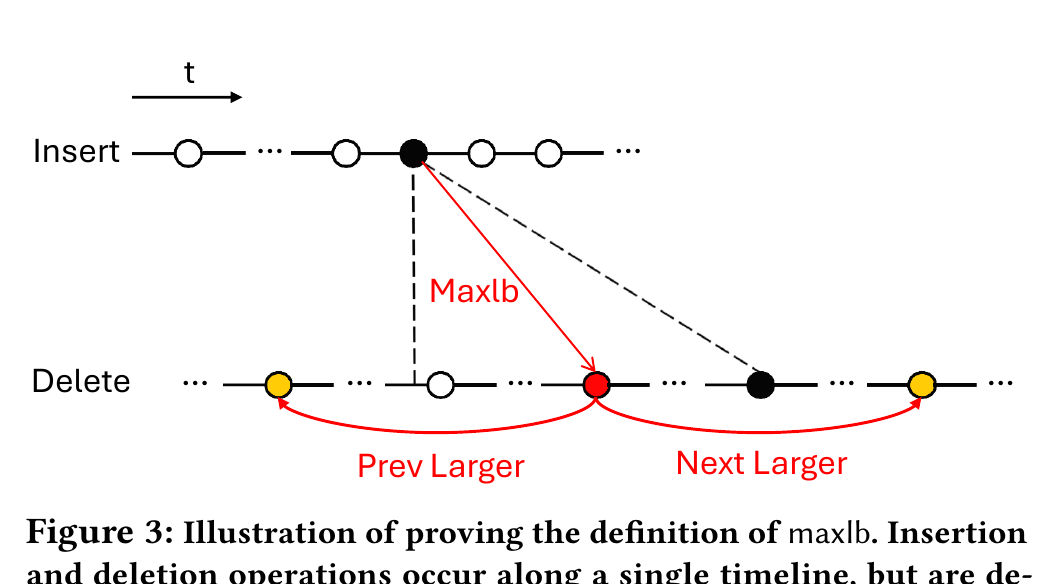
图:插入的存活区间内,所有删除的最大值就是它的 maxlb;验证 maxlb 定义正确即等价于验证优先队列性质(来源:论文原文图 3)
实验与数据
实现约 6000 行 Rust 代码,用 Faiss 搭建 HNSW,基线是通用证明框架 HyperPlonk 和 zkVM SP1,实验机是 16 核 Xeon 6126、200GB 内存,且不使用多线程加速。数据集用标准 SIFT 基准:100 万条 128 维向量、1 万条查询向量,建图参数 K=32。
先看主打配置:查询参数 efS=64,搜索轨迹长度 ℓq 落在 (2^11, 2^12] 区间(该基准下大多数实际查询的范围)。此时单次查询的证明者时间约 50 秒、验证者时间约 1 秒、证明大小 0.5MB。100 次查询的平均值更贴近日常:明文查询本身只要 13.86 毫秒,而证明要 26.0 秒(轨迹稍短的配置)、验证 0.93 秒、证明同样 0.5MB。50 秒对 14 毫秒——证明开销仍是三个数量级;它的进步在于把“完全不可用”变成了“离线或批量场景可用”。
规模扫描进一步确认了线性关系。只拉长底层搜索轨迹:轨迹 2^11 时总证明 26.0 秒,2^12 时 51.5 秒,2^13 时 101.7 秒,2^14 时 204.1 秒,基本翻倍增长;验证时间同期只从 0.93 秒爬到 1.13 秒,证明大小从 0.5MB 微增到 0.6MB。维度扫描同理:64/128/256 维下证明分别为 43.7/51.5/64.6 秒,验证时间和证明大小几乎不动。
基线对比最能说明“专用化值多少钱”。同样四组轨迹长度下,zkRAG 的证明时间分别是 13.3 秒、26.0 秒、51.5 秒、101.7 秒;SP1 需要 324 分钟、671 分钟、1404 分钟,第四组直接内存溢出;HyperPlonk 需要 493 分钟、1776 分钟,后两组同样溢出。换算下来,zkRAG 比 SP1 快 1000 倍以上、比 HyperPlonk 快 2000 倍以上。优先队列微基准差距更夸张:1024 次堆更新,zkRAG 只要 4.28 秒,SP1 要 46 分钟、HyperPlonk 要 394 分钟。
成本分解也指向了瓶颈:在轨迹为 2^11(上层)+ 2^12(底层)的配置下,总证明 51.5 秒里,向量表的混合查找占 24.8 秒、优先队列检查占 21.2 秒,两者合计约 89%。
相关工作对比
跟 zkRAG 最接近的,是用可验证数据结构(ADS)做 ANNS 验证的 VIS、ANNProof 一类工作:服务方返回验证对象,客户端据此复核。它们的硬伤有两个:一是验证时间和验证对象大小都随搜索轨迹增长,做不到简洁验证;二是验证对象本身会泄露数据库与索引结构,根本不是零知识。zkRAG 验证约 1 秒、证明 0.5MB,且验证者除结果外一无所知,补上这两块短板。
另一条线是隐私保护 ANNS:用同态加密、ORAM、PIR 把查询或数据库藏起来。它防的是“服务器偷看你的查询”,zkRAG 防的是“服务器在检索上偷工减料”;两者威胁模型正交,可以互补,不能互相替代。可验证机器学习与 zkLLM 一线则只管模型推理本身,检索环节一直是空白——zkRAG 补的正是这一段。
局限与开放问题
- 只证搜索、不证建图:证明的前提是“承诺的图就是按约定建好的图”。如果服务方一开始就恶意建图,搜索过程再正确,结果也可能被操纵。论文给出了组合出建图证明的高层路线,但明确留作未来工作。
- 静态数据库假设:证明针对建好后不再频繁变动的库,动态插入、删除与增量更新证明尚未解决,而真实 RAG 语料恰恰持续更新。
- 证明者成本仍高:50 秒对 14 毫秒的差距,决定了它目前只适合离线审计、批量验证或低频高价值查询,离“每次对话都实时验算”还很远;并行化、批处理与 GPU 加速是点名方向。
- 适用范围限于 HNSW:IVF、PQ、DiskANN 等其他 ANNS 路线尚未覆盖,检查器与查找论证能否通用化仍待验证。
- 隐私边界未封顶:证明不泄露数据库内容,但证明大小、时间这类侧信道仍可能泄露访问模式;彻底隐藏访问模式需结合 ORAM,超出本文范围。
一点思考
判断先说清楚:zkRAG 是“让可验证 RAG 从不可能变为昂贵但可行”的关键一步,而不是“明天就能上线”的工程方案。它的真正价值不在 50 秒这个数字,而在于专用证明把通用框架三个数量级的浪费砍掉,并且验证端已经便宜到可以常态化。我的建议是把它当作离线审计工具先用起来:定期抽查高价值查询、把证明和承诺一起归档,成本可控且能立刻发现服务方偏离;不要指望它实时护航每一次对话。在建图证明补上之前,任何“已验证 RAG”的宣传都只能说“搜索过程可验证”,不能说“检索结果可信”——这个措辞差别,是这篇论文留给行业最重要的一课。