TL;DR
清华大学团队在 NDSS 2026 上发表的 Pando,把 BFT 共识的规模天花板从约 100 个副本推到了 1000 个:在横跨 4 个大洲区域的 WAN 环境里,1000 个副本跑出 62.57 ktx/s 的峰值吞吐。做法是委员会抽样——每轮只让一小批副本投票,其余副本只管接收结果;抽签用 VRF,委员会身份在投票发出前不公开。最关键的一步在理论上:每轮共识换三批委员会,让安全失败概率从 降到 ;同样 的失败率,委员会只要 200 人,而 Algorand 需要 2000 人。代价是容错从最优的 降到 ,但 会随规模增大趋近于 0。
论文信息卡
- 标题:Pando: Extremely Scalable BFT Based on Committee Sampling
- 作者:Xin Wang、Haochen Wang(清华大学);Haibin Zhang(清华大学长三角研究院);Sisi Duan(清华大学、中关村实验室、山东区块链研究院)
- 会议:NDSS 2026(2026 年 2 月 23–27 日,圣迭戈)
- 原文链接:https://www.ndss-symposium.org/wp-content/uploads/2026-s273-paper.pdf
- 完整版:https://eprint.iacr.org/2024/664
- 开源代码:https://github.com/DSSLab-Tsinghua/Pando
背景
BFT(拜占庭容错)是许可链的默认共识模型。但它有个出名的扩展性诅咒:副本数 一上去,性能就断崖式下跌。反观以太坊这样的非许可链,验证者数量超过 100 万(2025 年 4 月 beaconcha.in 数据)。一百万对一百,这个差距就是 BFT 研究二十年没填上的坑。
填坑的思路有几条。分片把网络切成多个小 BFT 分片,但跨分片开销和安全假设都不便宜;并行化能榨出一些吞吐,但治标不治本。近几年最有希望的是”解耦”路线:把”传区块”(搬运交易数据)和”定顺序”(对区块顺序达成共识)分开,共识只处理区块哈希或签名证书,不再被大数据拖累。Narwhal/Bullshark、Dumbo-NG、Star 都是这条路线的代表作,其中 Star 在 91 个副本的 WAN 环境下做到 256 ktx/s,是当时最能打的方案。
但解耦路线也有天花板:大约 100 个副本。论文的实验里,Narwhal 和 Star 在低端虚拟机上超过 100 个副本就根本启动不起来,反复报”connection refused”。瓶颈有两个,都和 有关:通信上,所有副本两两直连的 -to- 模式让消息量随 膨胀;计算上,每个 quorum certificate(QC)要攒 个签名,门限签名又随 变大而变慢。想冲到 1000 个副本,必须把”全员参与”这个前提本身拆掉。
方法拆解
Pando 的思路一句话概括:共识只让委员会干,全网只负责收结果。论文沿用解耦框架,协议分三段流水线:传输——每个副本发提案、收集签名形成 QC;共识——只对 QC 的顺序达成一致;状态同步——没拿到提案的副本事后去补数据。
传输:只让委员会回签名
传统的一致广播(CBC)里,提案者把区块发给所有人,再等 个签名回来。Pando 只改了一个地方:每轮每个实例抽一个 人委员会,只有委员会成员才回签名。提案者攒够 个签名就形成 QC,其中 。
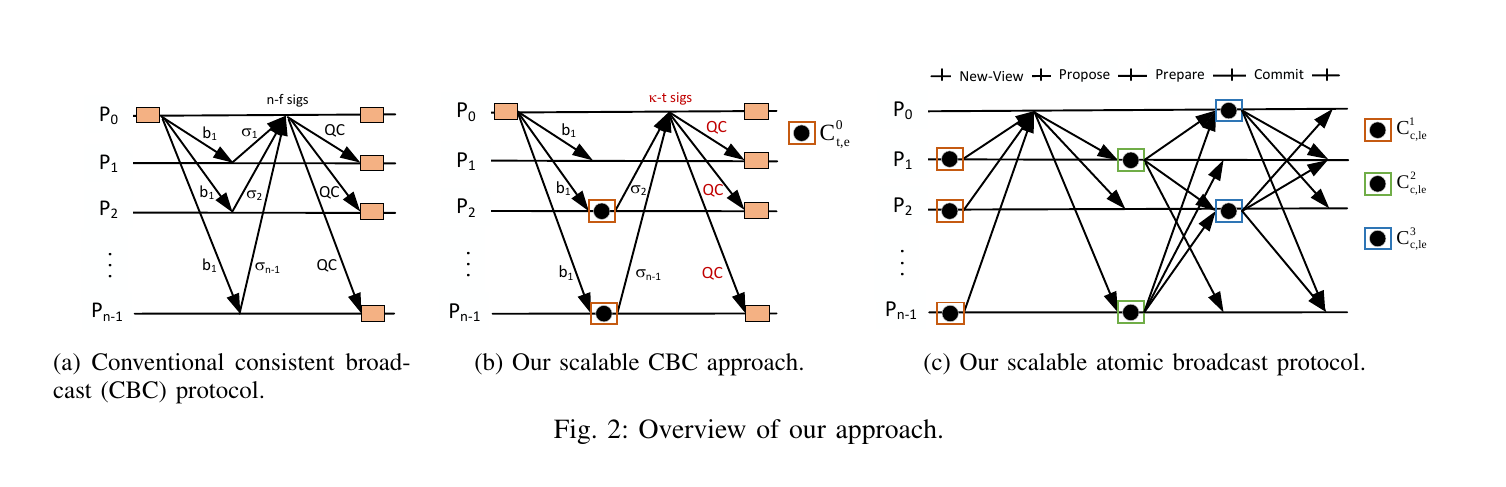
图:Pando 的整体思路:传统 CBC 要全体副本回签名,Pando 只让 人委员会回签;共识每轮换三批委员会投票(来源:论文原文)
这一改带来两个直接好处:回签名的副本数从 降到 (与 无关的安全参数),通信不再随 膨胀;QC 从 个签名缩到 个,共识要处理 个 QC,每个 QC 变小,共识的通信量也随之变小。复杂度对比很直观( 是区块大小, 是安全参数长度):
| 协议 | 传输过程通信 | 共识过程通信 |
|---|---|---|
| Narwhal / Bullshark | ||
| Dumbo-NG | ||
| Star | ||
| Pando |
改进集中在 这一项上:原来是 ,现在是 。 越大,省得越多。
共识:每轮换三批委员会
共识过程是一个原子广播协议,分 New-View、Propose、Prepare、Commit 四个阶段,每轮 leader 按 轮换。关键设计在 Prepare 和 Commit 阶段:每轮采样三个委员会 、、,分别用于 New-View、Prepare、Commit;每个委员会成员投完票就不再投票。
“投完即走”是整篇论文对付自适应敌手的核心。委员会抽样过去只在静态敌手模型下成立:敌手开局就定好要腐蚀谁。自适应敌手可以在协议运行中途、看到谁进了委员会之后再下手腐蚀。Pando 的回答是让腐蚀”为时已晚”——投票已经发出去了,再腐蚀这个副本也改不了什么。论文假设弱自适应敌手加”原子发送”:副本要么在发消息前被腐蚀,要么在发完之后被腐蚀,不能中途篡改已发出的消息。
三委员会还有一个附带的好处,直接决定了委员会能压多小。安全被攻破需要 Prepare 和 Commit 两个委员会同时”坏人超标”,失败概率从 变成 —— 是单个委员会坏人超标的概率,两个独立的小概率事件同时发生,概率是乘积。论文指出,多加一个阶段还能进一步压到 ,实现里用的是两阶段版本。
数学:Chernoff 界的新用法
委员会到底要多大?论文用 Chernoff 界给了一个新 bound(引理 1):设系统坏副本占比 ,想让委员会内坏人不超过 的失败概率低于 ,委员会规模取 即可。直觉是委员会是全网的随机样本,坏人占比偏离全网水平的概率随委员会增大指数衰减。
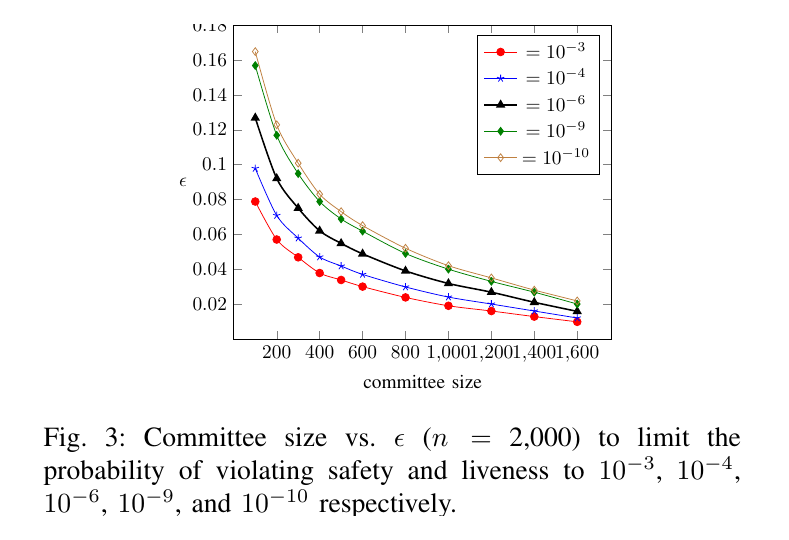
图:委员会规模与容错代价 的关系():委员会越大, 越小、容错越接近最优 ;五条曲线按失败率 到 分层(来源:论文原文)
这张图就是 Pando 的理论底气:同样 失败率,Algorand 要 2000 人委员会,Pando 只要 200 人;同样 失败率和 ,旧方法要约 400 人。更具体地看论文表 II(失败率 ):、委员会取 时 ,即容错 ,已经很接近最优的 ;而 、委员会取 时 ,容错只剩 ——小网络的代价明显更大。
抽签:VRF 暗箱
委员会成员怎么选?用可验证随机函数(VRF)。每个副本对”过程 + epoch + 实例号”做一次 VRF 求值,结果低于难度阈值 就入选,入选后把 VRF 证明附在消息里,其他副本用 ComVerify 验证。身份在投票发出前不公开,发出后可验证。VRF 开销很小:每轮每副本做 次查询,实测 ComProve 每次 2.8ms、ComVerify 每次 0.1ms。
状态同步:O(κn) 条消息
以前的状态同步是全员互查, 条消息。Pando 同样用委员会:对每个提案抽一个分发委员会,持有该提案的委员会成员把它广播给所有人,收到者拿哈希校验——QC 里有提案哈希,哈希对不上就拒收。消息量降到 。
实验与数据
实现是 Go 语言,协议约 1 万行代码、评测约 1000 行,开源在 GitHub;通信用 gRPC,认证用 HMAC、哈希 SHA-256、纠删码 Reed-Solomon。评测在 AWS EC2 上做,最多 500 台虚拟机、1000 个副本,均匀分布在 4 个区域的 WAN 环境;默认交易 250 字节,每组实验重复 5 次取平均。
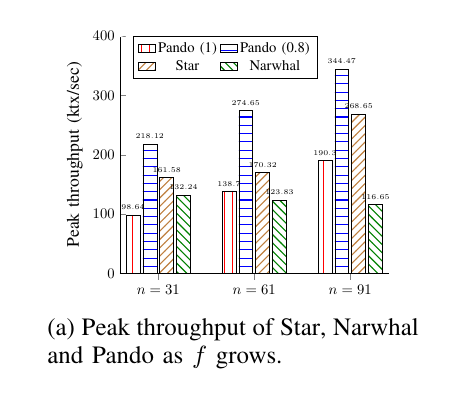
图: 时四种协议的峰值吞吐:Pando(0.8) 在 达到 344.47 ktx/s,比 Star 高 28.22%(来源:论文原文)
先看小规模对照。 时,Pando(0.8) 的峰值吞吐是 344.47 ktx/s,比委员会取全员的 Pando(1) 高 81.01%,比 Star(268.65 ktx/s)高 28.22%。Pando(1) 因用 CBC 而非弱 CBC、又多了 VRF 计算,略低于 Star,但始终高于 Narwhal(116.65 ktx/s)。Narwhal 和 Star 在这组低端机(4 vCPU)上超过 100 副本就启动失败,连跑都跑不起来。
再看规模扩展。委员会取 时,250 字节交易的峰值吞吐随 变化是: 时 2947.44 ktx/s, 时 2812.40, 时 1558.42, 时 600.96, 时 158.25。吞吐随 下滑是符合预期的——提案还是要广播给所有人, 的传输项躲不掉;但关键是它还能跑,而前人到 100 就停了。
重头戏是 1000 副本。同一批 m5.xlarge 机型上跑不出任何吞吐,换成高带宽的 m5n.2(200 台虚拟机),Pando 达到 62.57 ktx/s;加到 500 台虚拟机是 73.2 ktx/s,提升有限,说明瓶颈不在机器数量。而带宽差的 c5.4xlarge 只有 1.6 ktx/s。论文的部署结论很直接:大规模下瓶颈从 CPU 变成了带宽,要高带宽、中等 CPU 的机器。顺带一提,最低配的 t2.micro(1 vCPU、1 GiB 内存)在 时仍有 95.37 ktx/s——协议对机器要求并不高。
和 Algorand 的对比最能说明委员会缩小 10 倍的价值。同样 失败率,Algorand 论文里用 1000 台虚拟机跑 5 万副本、22 秒才交付 2 MB 交易;Pando(0.4) 1 秒交付 13.84 MB,约 154 倍。本地 7 节点测试网同条件对比:Pando(1) 75.21 ktx/s,Algorand 5.72 ktx/s,约 13.15 倍。差别主要来自 Algorand 每轮只定一个区块提案,而 Pando 每轮至少定 个。
状态同步的改进也很直观: 时,Pando(0.4) 的状态同步延迟是 911 ms,而 Pando(1) 是 27203 ms,只有后者的 3.3%。不过 后,共识过程的延迟反而超过了传输过程,主因是 QC 用签名集合实现、体积太大,换聚合签名可以缓解,但实现里没做。
相关工作对比
和 Algorand 比,Pando 是”委员会抽样”从理论走向实用的第二步。Algorand 是第一个实用的 VRF 委员会抽样协议,但它解决的是拜占庭 agreement(BA)问题、每次只定一个区块,且委员会要 2000 人。Pando 解决的是带客户端的 BFT/原子广播问题,每轮定 个提案,委员会 200 人就够。Pando 的带宽利用更均衡:所有副本都能提案,而不是只有一个 leader。
和 King-Saia 的采样器、Abraham 等人的亚二次通信 BA/BC 工作比,Pando 把委员会抽样从理论协议搬进了可部署的 BFT 系统。那些工作聚焦 BA/BC 问题本身,通信复杂度做到亚二次,但没处理 BFT 的客户端模型、传输与共识解耦、状态同步这些工程环节。Pando 的三段式改造——可扩展 CBC、原子广播、状态同步——每一个都可以独立使用。
和 Narwhal、Bullshark、Dumbo-NG、Star 这些解耦路线的前辈比,Pando 不是另起炉灶,而是在它们的框架上把”全员参与”换成了”委员会代劳”。它只是在 Star 的三段流水线上把每一段的 换成 。代价是容错从最优的 降到 ,以及安全性从确定性变成概率性( 到 量级)。
局限与开放问题
- 容错不是最优:, 只有在 足够大时才趋近于 0。小网络下代价明显:、委员会 时 ,容错只剩 ,比 差了一倍多。
- 安全是概率性的:失败率 到 是可以调的参数,但不是确定性保证。部署时必须按网络规模查表选委员会大小和 ,选错就直接牺牲安全性。
- 依赖 atomic sends 假设:弱自适应敌手模型要求消息”要么发前被腐蚀、要么发后被腐蚀”。真实 TCP 的 transmit-ack-retransmit 模式下,敌手可能提前获知信息,作者把这点列为未来工作。
- QC 体积仍是瓶颈:实现里 QC 是签名集合而非聚合签名, 后共识延迟反超传输延迟;聚合签名能缓解,但没有实测数据。
- 实验上限 1000 副本:受 AWS 账号 500 台虚拟机限制,更大规模的表现论文未披露;状态同步通信仍有 的 因子。
- 只覆盖部分同步网络:异步 BFT 的委员会抽样版本不在本文范围。
一点思考
Pando 最值得学的不是某个具体协议,而是一种”降维”思路:BFT 扩不上去的根因是全员参与,把”谁干活”和”谁验收”分开——委员会干活、全网验哈希——规模瓶颈就从 的参与成本降到了 。判断上说一句:它离真正落地还有两步,一是把概率性安全的参数选择做成开箱即用的默认值,二是补上聚合签名、把共识延迟的尾巴收掉;但作为一篇 NDSS 论文,它把委员会抽样从”理论上可行”推进到了”1000 副本实测可用”,这个跨度本身就够分量。对做联盟链和许可链的团队来说,Pando 的代码开源,值得直接拿来跑一跑。
原文链接
- 论文(NDSS 2026):https://www.ndss-symposium.org/wp-content/uploads/2026-s273-paper.pdf
- 完整版(Cryptology ePrint 2024/664):https://eprint.iacr.org/2024/664
- 开源代码:https://github.com/DSSLab-Tsinghua/Pando