TL;DR
DeFi 被盗的新闻隔三岔五就有一条,但事后复盘再精彩,也追不回已经转走的钱。真正有用的防线,是在攻击交易上链之前就把它拦下来。NDSS 2026 的 HOUSTON 走的就是这条路:它不依赖任何已知漏洞模式,而是给每个 DeFi 协议自动学一套“正常行为”——协议的函数通常以什么顺序被调用(交互模型),以及函数参数与合约存储之间通常满足什么关系(不变量模型)。新交易一旦偏离这套行为基线,系统立刻报警。在 115 起真实 DeFi 攻击、超过 2200 万笔交易的历史回测里,HOUSTON 检出了 109 起攻击(94.8%),误报率只有 0.16%;实地部署 20 天监测 20 个协议,只报了 75 起警报,且端到端中位延迟 0.148 秒,远低于以太坊 12 秒的出块间隔,完全跟得上实时拦截的节奏。
论文信息卡
- 标题:HOUSTON: Real-Time Anomaly Detection of Attacks against Ethereum DeFi Protocols
- 作者:Dongyu Meng、Fabio Gritti(共同一作)、Robert McLaughlin、Nicola Ruaro、Ilya Grishchenko、Christopher Kruegel、Giovanni Vigna(加州大学圣塔芭芭拉分校、多伦多大学)
- 会议:NDSS 2026(2026 年 2 月 23–27 日,圣迭戈)
- 原文链接:https://www.ndss-symposium.org/ndss-paper/houston-real-time-anomaly-detection-of-attacks-against-ethereum-defi-protocols/
- DOI:10.14722/ndss.2026.241534
背景
先看一组数字:论文写作时,以太坊市值约 4500 亿美元,链上 DeFi 协议锁仓总值(TVL)接近 820 亿美元,而 DeFi 攻击累计造成的损失已经超过 50 亿美元,平均每周都有数百万美元被盗。智能合约一旦部署就不可更改,漏洞就是直接敞开的提款口。
安全社区分两条线应对。部署前找漏洞的工具已经很多,但拦不住“业务逻辑漏洞”——只有读懂协议业务才能发现的问题,比如借贷协议里抵押率算错了,代码跑得好好的,逻辑却是错的。部署后监测则分两种做法:模式匹配(比如 DeFiRanger)精确但只能认已知攻击;异常检测(比如 BlockGPT)通用但误报高、报警不可解释,分析师拿到“模型觉得不对劲”的警报,往往不知道从何查起。
HOUSTON 的切入点是把异常检测的信号换掉:不用高维向量、不用黑盒模型,而是从交易执行轨迹里自动提取两类语义明确的信号——协议的函数通常以什么顺序被调用(交互模型),以及函数参数与合约存储之间通常满足什么关系(不变量模型)。两类信号都针对每个协议单独学习、持续更新,报警时能直接指出“哪个调用序列从没出现过”或“哪条不变量被违反了”,天生可解释。
方法拆解
HOUSTON 的流水线分八步,核心是两个分析模块加两个检测模型。先看总览:
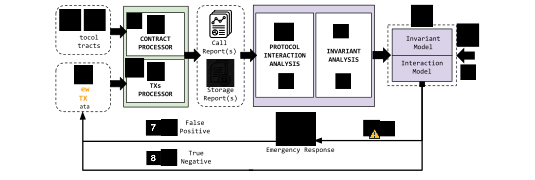
图:HOUSTON 系统总览(来源:论文原文)
第一步:把协议的合约找齐、把存储读准
系统先要知道一个 DeFi 协议由哪些合约组成(部署时由管理员提供),再用 Solidity 工具链提取每个合约的 ABI 与存储布局。这里有个 EVM 特有的坑:多个变量可以打包在同一个 32 字节存储槽里,比如论文自创的演示协议 TicketMonster,is_open(布尔值)和 admin(地址)就挤在 0 号槽里,只看槽 ID 根本分不清谁是谁。
论文为此写了一个“存储变量解码器”(SVD):结合合约的存储布局和交易执行中所有 KECCAK256 操作的原像(输入),把对动态结构(如 mapping)的访问反解回具体的变量。例如 balances 映射存在 5 号槽,要读某个用户的余额,EVM 会算 KECCAK256(用户地址.5) 得到真正的存储位置;追踪器记下所有这类哈希的原像,就能把“写了某个哈希地址”翻译成“改了某个用户的余额”。没有这一步,后面的不变量分析无从谈起。
第二步:追踪交易,产出两份报告
HOUSTON 接在以太坊归档节点(Erigon)上,用自定义追踪插件记录每笔相关交易的执行轨迹,只关心五类操作码:SSTORE(写存储)、CALL / DELEGATECALL / STATICCALL(函数调用)和 KECCAK256。处理后产出两份报告:调用报告(Call Report,记录所有调用及经 ABI 解码后的参数)和存储报告(Storage Report,记录每个存储变量的修改,经 SVD 精确到变量级别)。这两份报告是后面两个模型的共同原料。
第三步:交互分析——把一笔交易压成“指纹”
一笔 DeFi 交易的调用轨迹可能长达数百次嵌套调用,大部分与攻击无关。HOUSTON 的交互分析只保留“关键调用”,分四步过滤:
- 只看进入协议的调用:调用方在协议之外、被调方在协议之内。协议内部调用和向外调用一律丢掉,大幅降噪。
- 判定关键调用:一个进入协议的调用是关键的,当且仅当它(或其调用子树里的任何函数)改了协议合约的存储,或者触发了四个标准 ERC20 函数之一:
transfer、transferFrom、safeTransferFrom、approve。这两类操作分别对应“改状态”和“动钱”,是协议的核心动作。 - 过滤直接的 ERC20 操作:用户直接调协议代币合约的
transfer这类操作量大、与攻击基本无关,直接从指纹里去掉。但如果一个非 ERC20 函数(如pay)在内部触发了代币转账,这次转账仍算进指纹。 - 生成指纹:剩下的关键调用序列就是这笔交易的“指纹”,存入指纹库。正常用户的买票交易指纹只有一个
[buy];而 Euler 攻击交易原本有 150 次调用,压完只剩 8 个,恰好就是安全专家事后复盘里描述的攻击步骤。
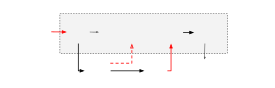
图:协议交互分析示例(来源:论文原文)
第四步:不变量分析——给协议立“家规”
交互模型看的是“调用顺序”,不变量模型看的是“数据关系”。论文借用经典的 Daikon 思想,从历史交易里动态推断“可能不变量”(likely invariants):在足够多的执行里始终成立的变量关系。先在 16 起攻击的试点集上反复筛选,最终只保留四类语义清晰、实战中确实会被攻击违反的不变量:
- C1:单个整数变量从不为零;
- C2:单个地址或字节变量恒等于某个值,或取自一个固定集合;
- C3:两个整数变量之间恒成立的大小关系(=、≥、≤);
- C4:两个字符串、地址或字节变量恒相等。
比如在演示协议 TicketMonster 里,buy 函数的 token 参数历史上只取过 0xUSDC 或 0xUSDT,这就是一条 C2 不变量;攻击者拿自己部署的假代币来“付款”,立刻违反这条不变量。
暴力枚举所有变量对会产生大量无意义的二元不变量(比如 timeStamp < reserve),论文用 GPT-4.1 预先判断每对变量在语义上是否可比,只挖掘可比的对。这一步让不变量模型的误报减少了 27.2%(从 10,579 起降到 7,702 起),真阳性一个没少,整个数据集只花了约 100 美元的 LLM 额度。
新协议冷启动时数据太少,推断出的不变量可能只是巧合。论文设了一个等待期:不变量需要至少 10 笔交易支撑、且合约年龄超过 12 小时,等待期内即使被违反也只丢弃该不变量、不报警。实验表明检测结果对这组参数并不敏感。
第五步:双模型判定与持续学习
新交易进来时,两个模型各自独立判断:交互模型查指纹是否见过,没见过就报警;不变量模型检查是否违反已建立的不变量,违反就报警。任一模型报警,系统就触发警报,可由人工复核,也可驱动自动响应——比如触发协议的紧急暂停,或者交给白帽抢跑系统先一步把资金救出来。没报警的交易则进入语料库:新指纹入库、不变量被重新挖掘或增强置信度,模型随协议演化而演化;被人工确认为误报的交易同样回流,同类误报不再重复出现。
实验与数据
数据集:115 起真实攻击,2200 万笔交易
评估用的基准是作者整理的 115 起 DeFi 攻击事件,每个事件对应一个不同的协议,涵盖多种应用类型和漏洞类别,附带被攻击合约地址、区块、日期和首笔攻击交易的哈希。评估方法是“历史重放”:把协议在首次被攻击之前的所有交易按时间顺序喂给 HOUSTON,只看它能否在攻击交易上报警;攻击交易记为真阳性,之前的任何报警都算误报——这是个偏严格的口径,因为历史上的报警里可能混着未被公开的真实攻击。
总成绩:检出 94.8%,误报 0.16%
在 8,586,421 笔交易里,HOUSTON 检出 109 起攻击(94.8%),误报 13,827 起,误报率 0.16%,平均每个协议每天 0.4 起误报。更重要的是报警质量:作者逐一对照了 109 起检出事件的公开事后复盘,把报警信号分成三档——因果型 57 起(52%),报警直接指向漏洞根因,没有这条异常攻击就不可能成功;指示型 43 起(39%),报警反映的是攻击的后果或攻击者的意图;偶然型 9 起(8%),报警与攻击无关,多发生在协议部署早期、交易路径本身就很新的时候。
两个具体案例最能说明问题。Revest Finance 是一起重入攻击:不变量模型发现,进入 mint 函数时 fnftID 与 fnft_created 这两个本应相等的存储变量出现了偏差(C3 类不变量),而这个偏差正是重入得以成立的前提,属于因果型检出;交互模型也发现 mintAddressLock 在一笔交易里被调用了两次,此前从未出现过。Euler 则是约 2 亿美元的借贷协议大案:攻击者利用 DonateToReserve 的逻辑错误抬高了借款与抵押资产的兑换率。交互模型抓到了关键序列——donateToReserves 之后紧跟 liquidate,这是攻击成立的必要步骤;不变量模型则发现,liquidate 执行时 deferLiquidityStatus 第一次为零(C1 类不变量),因为攻击者跳过了正常用户都会调用的 deferLiquidityChecks 安全检查。
6 起漏报也有明确原因:4 起需要挖掘更多类型的不变量(比如 Nomad 事件需要对“读存储”的值建立不变量,而当前系统只看存储写);AzukiDAO 在部署仅 4 天后就被攻击,系统还没攒够学习数据;Snood 的攻击直接针对协议自己重实现的有 bug 的 transferFrom,而直接调用 ERC20 的交易在交互分析里被过滤掉了。
误报从哪来:冷启动是主因
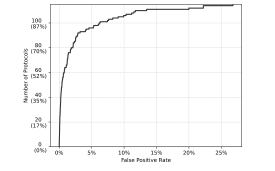
图:各协议误报率的累积分布(来源:论文原文)
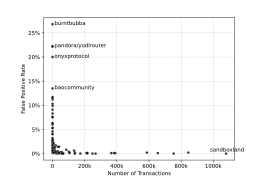
图:误报率与协议历史交易总数的关系(来源:论文原文)
误报主要来自三处。第一是冷启动:历史交易少于 800 笔的协议最容易误报,误报率超过 3% 的 23 个协议全部属于这一档;数据攒够后误报率迅速下降,64 个协议(55.7%)的误报率不超过 1%,92 个协议(80%)不超过 3%。论文建议用自己的测试用例或仿真交易给模型“预热”。第二是不变量质量:随机抽查 100 条挖掘出的不变量,84 条语义合理,16 条是伪不变量(比如错误地认定 allowance 的 spender 参数只能取少数几个地址),GPT-4.1 预筛已经去掉了大部分,更好的推理模型还能进一步压缩。第三是指纹的排列组合:同一笔交易里“五次存款加一次取款”,取款插在不同位置会产生六种不同的指纹;按逻辑实体(如一笔质押)分组能缓解这个问题。
作为对照,作者又在一批从未被攻击过的头部协议(TVL 超过 5 亿美元,截至区块 20400000 共 1300 多万笔交易)上跑了同样的实验,误报率只有 0.08%——协议越成熟、用得越多,HOUSTON 越安静。
实时性能:跟得上 12 秒的出块节奏
实时检测的硬指标是:必须在一个区块产生的时间(以太坊约 12 秒)内完成对该区块全部交易的评估。附录的性能表显示,端到端耗时平均 0.211 秒、中位数 0.148 秒、99% 分位 1.165 秒、最大值 3.085 秒,全部落在 12 秒以内。
2024 年 4 月 9 日至 28 日的实地部署更说明问题:20 个协议并行监测 20 天,系统观测了 4260 万笔交易,其中 50.2% 是纯 ETH 转账或基础代币调用、直接过滤掉,与被监测协议相关的有 95,600 笔,平均每秒约 13 笔待追踪交易、每个区块约 1 笔需要深度处理,最终只报了 75 起警报(0.08%),9 个协议全程零报警,唯一的例外是 ConicFinance(24 起报警、占其 901 笔交易的 2.7%),原因是新上线的 ConicPool 地址触发了一批不变量。随后 2025 年 10 月 27 日至 11 月 16 日又补了 3 周实验:108,500 笔相关交易、71 起报警(0.07%),人工复核确认没有一起是攻击。最坏情况下的资源需求约为 110GB 内存、120 核,一台现代服务器就能承担;实地部署只用了 8 个追踪 worker、4 个处理 worker 和 20 个检测 worker,内存峰值约 80GB、CPU 平均负载 8.0(112 核机器)。
与现有系统的对比
在 28 起共同样本上,HOUSTON 检出 27 起,BlockGPT 只检出 15 起;误报率低于 10% 的协议占比,HOUSTON 是 92.2%,BlockGPT 只有 58%。规则驱动的 TXSPECTOR 在 115 起攻击里只检出 25 起(21.7%),因为它只覆盖重入、未检查调用等几类写死的模式;DeFiRanger 在其专长的价格操纵领域 6 起全中,但数据集中 74.8% 的攻击根本不在它的覆盖范围。防御性抢跑系统 APE 在 20 起重叠攻击里只反制了 4 起,HOUSTON 检出 19 起,同期误报率 0.15% 对 0.10%。就连“交易越长越可疑”这种社区常识也被量化证伪:只看调用长度的基线方法只能检出 46 起(40%)。
作者还把系统移植到了 BNB 智能链(BSC):20 起事件里 12 起可用,检出 11 起,误报率 0.19%。唯一“漏掉”的 pdz 事件颇具戏剧性——HOUSTON 其实在标注事件发生前 202 天就报过一笔高度相似的价格操纵交易,只是一直没人公开报道,协议方似乎也不知情。
相关工作对比
与部署前的安全工具相比,HOUSTON 不试图证明代码没漏洞,而是假设漏洞存在、盯住利用行为,两者互补。与部署后的同类系统相比,差别主要在三点:模式匹配系统(DeFiRanger、TXSPECTOR)精确但覆盖窄,只能认已知攻击;神经网络异常检测(BlockGPT)通用但黑盒,报警难以复核;商业监测产品(Hexagate、Hypernative 等)通常要求开发者手工编写检测规则。HOUSTON 的报警直接对应一条被违反的不变量或一个从未见过的调用序列,规则则是自动从协议自己的历史里学出来的,不需要人工标注。代价是它依赖源码:没有 ABI 和存储布局的纯二进制合约只能做交互模型——不过用 LLM 反编译恢复 ABI 和存储布局的最新研究已达到约 49.8% 的重编译成功率,这条路正在变通。
局限与开放问题
- 依赖源码:不变量模型的精度建立在合约 ABI 与存储布局之上;纯二进制合约只能参与交互模型,检测能力会打折扣。
- 看不见私有交易:攻击交易如果走 Flashbots 这类私有中继、不进公开 mempool,系统就无法在上链前拦截。Revest 事件的攻击就是 4 笔私有交易、在约 17 分钟内分两个区块完成的;但 HOUSTON 能在第一笔上链后立刻报警,给管理员争取时间叫停后续攻击。
- 可能被“投毒”:攻击者理论上可以利用管理员的罕见操作来“洗白”异常行为——比如先等管理员某次操作触发一条不变量报警,等安全团队把它当作正常管理行为 dismissed,系统就会把该行为纳入“正常”,攻击者再复现同一行为就不再报警。但这要求攻击者精准对齐罕见的管理事件,还得赌安全团队误判,攻击门槛仍然很高。
- 冷启动误报:新协议交易量少时误报偏高,可用测试用例或仿真交易预热模型来缓解。
- 不在射程内的问题:Rug pull、私钥丢失、治理接管这类“有权限者作恶”,以及 MEV 抢跑、三明治攻击这类不针对代码缺陷的行为,都不在 HOUSTON 的设计目标里。
一点思考
HOUSTON 最值得借鉴的不是某个具体算法,而是它选信号的眼光:与其让黑盒模型在高维交易向量里自己找规律,不如先把协议的业务语义提炼成“调用顺序”和“数据关系”这两类人能看懂的信号,再做异常检测——可解释性在这里不是锦上添花,而是决定了报警能不能被用起来。对协议方来说,部署这类系统的现实门槛其实不高:它不需要改合约、不需要链上操作,纯链下监测就能跑;但前提是团队得真的有人值班看报警,并把紧急暂停这类响应机制事先接好,否则再快的检测也只是事后诸葛亮。